

AIPractix · Technical Engineering · Kiến trúc hệ thống
1. Giới thiệu
Retrieval-Augmented Generation (RAG) kết hợp mô hình ngôn ngữ với thông tin được truy xuất từ nguồn tri thức xác định. Giá trị chính không phải là tạo câu trả lời dài hơn, mà là giúp phản hồi có căn cứ từ tài liệu người dùng hoặc hệ thống được phép sử dụng.
Một proof of concept có thể chia vài PDF thành chunk, tạo embedding và đưa top kết quả vào prompt. Production RAG cần thêm ingestion, quản lý quyền, cập nhật dữ liệu, đo chất lượng, kiểm soát trích dẫn và chống nội dung không đáng tin cậy.
2. Tách retrieval khỏi generation
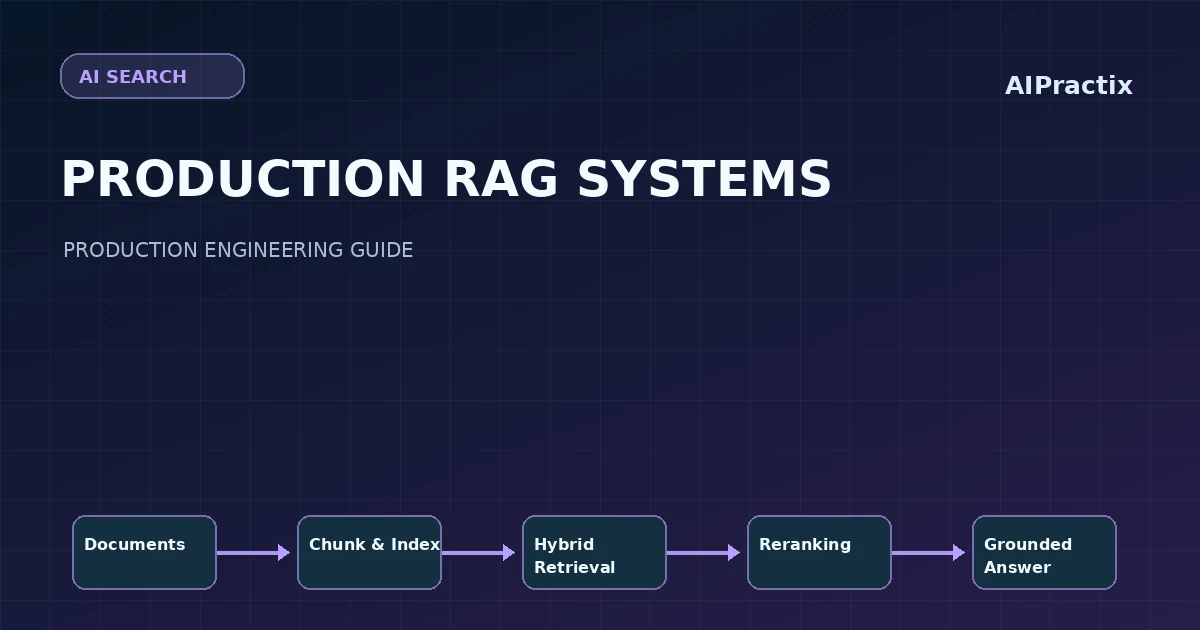
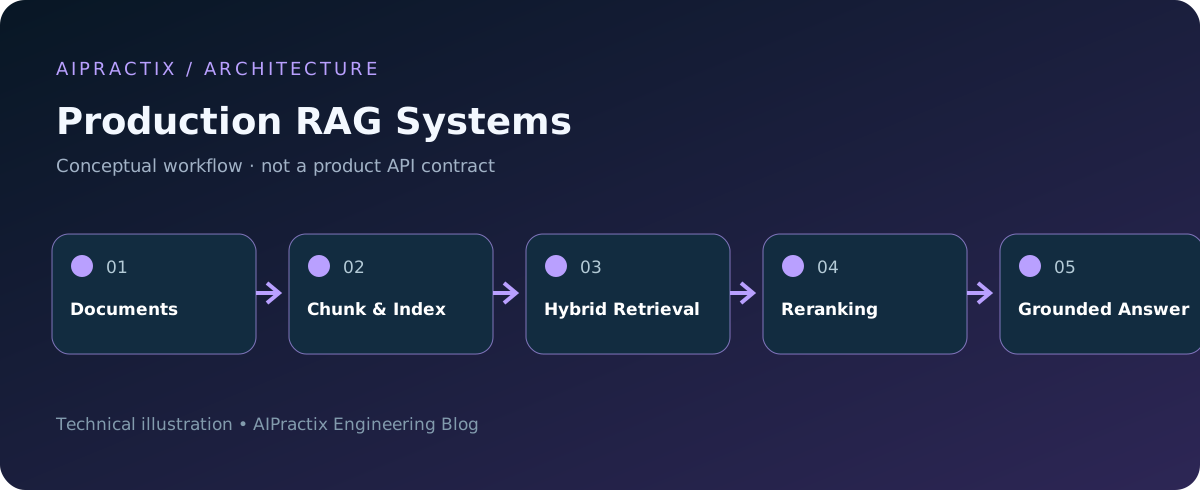
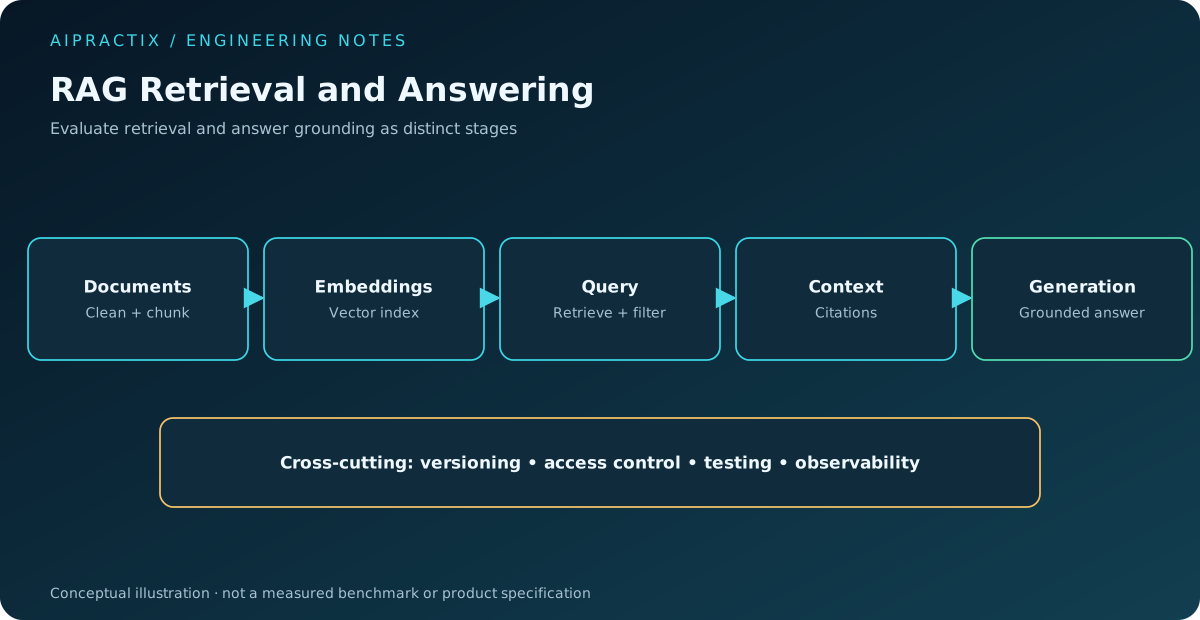
Một pipeline phổ biến gồm document parsing → chunking → embedding/index; khi có câu hỏi, hệ thống xử lý truy vấn → retrieval/reranking → xây dựng context → LLM → trả lời kèm nguồn tham chiếu.
Mỗi bước có kiểu lỗi riêng. LLM mạnh không thể trích dẫn chính sách chưa được truy xuất; bộ retriever tốt cũng không tự ngăn mô hình phát biểu vượt quá bằng chứng. Hãy đo lường và debug từng lớp độc lập.
3. Bắt đầu từ chất lượng tài liệu
Tài liệu có thể chứa bảng, ảnh, footer, nhiều cột, phiên bản trùng lặp hoặc scan thiếu text. Nếu parser làm mất cấu trúc, embedding chất lượng cao cũng khó cứu kết quả tìm kiếm.
Cần lưu metadata như document ID, version, page/section, nguồn, thời điểm cập nhật và quyền truy cập. Chunking nên giữ đoạn có ý nghĩa và ngữ cảnh tiêu đề; không nên cắt ngang quy tắc quan trọng chỉ để đạt kích thước token cố định.
4. Chọn chiến lược retrieval có chủ đích
Dense retrieval dùng embedding để tìm ngữ nghĩa tương tự; sparse/keyword retrieval tốt cho mã sản phẩm, số hiệu hoặc thuật ngữ chính xác; hybrid search kết hợp ưu điểm của cả hai.
Sau bước lấy ứng viên, reranker có thể xếp lại theo mức phù hợp câu hỏi. Cần đo Recall@K, MRR/NDCG hoặc chỉ số thích hợp trên bộ câu hỏi có đáp án và nguồn đúng. Không nên chọn chiến lược chỉ dựa trên một số ví dụ demo.
5. Thực thi phân quyền ngay trong retrieval
Nếu công ty có tài liệu nhiều phòng ban hoặc nhiều khách hàng, không được để người dùng truy xuất chunk thuộc tenant khác. Lọc quyền phải nằm trong truy vấn retrieval, không chỉ trong prompt hay giao diện.
Quyền có thể thay đổi theo người dùng, nhóm, dự án, thời gian hoặc phiên bản tài liệu. Cache và index cũng phải tuân thủ các thay đổi này. Một RAG trả lời rất chính xác từ tài liệu không được phép vẫn là một hệ thống thất bại.
6. Thiết kế chính sách câu trả lời
Một policy production nên yêu cầu trả lời dựa trên context, dẫn nguồn chính xác và thừa nhận khi tài liệu không đủ. Cần tách nội dung được truy xuất (dữ liệu không đáng tin cậy) khỏi chỉ dẫn hệ thống để giảm nguy cơ prompt injection.
Câu trả lời nên biểu đạt mức chắc chắn theo bằng chứng, không tự suy diễn các con số hoặc điều khoản chưa có trong tài liệu. Các trích dẫn cần dẫn đến đoạn hỗ trợ thực sự, không chỉ hiển thị tên file tượng trưng.
7. Đánh giá hai lớp riêng biệt
Ở lớp retrieval, đo xem hệ thống có tìm đúng tài liệu/chunk hay không. Ở lớp generation, đo tính đúng sự thật, độ đầy đủ, mức bám nguồn, chất lượng trích dẫn và khả năng từ chối khi thiếu dữ liệu.
Hãy xây tập câu hỏi đại diện gồm câu có đáp án, câu không có đáp án, câu cần nhiều nguồn và câu mơ hồ. Khi chất lượng giảm, phân tích xem lỗi nằm ở parser, chunking, search, reranker hay LLM trước khi thay model.
8. Kiểm soát chi phí và độ trễ
Chi phí RAG đến từ embedding, lưu index, retrieval, reranking và token LLM. Một hệ thống gửi quá nhiều chunk vào context có thể vừa chậm, vừa đắt, vừa khiến mô hình khó tập trung vào bằng chứng chính.
Cân nhắc tối ưu chunk size, top-K, cache an toàn theo quyền và lựa chọn model phù hợp nhiệm vụ. Theo dõi p50/p95 latency, cost/query, tỷ lệ lỗi và mức độ hữu ích của câu trả lời, không chỉ token throughput.
9. Lên kế hoạch cập nhật liên tục
Nguồn tri thức có thể thay đổi hằng ngày. Cần ingestion tăng dần, cập nhật hoặc xóa chunk cũ, quản lý phiên bản embedding và tái index khi thay model. Không thể chỉ upload tài liệu một lần rồi cho rằng RAG luôn trả lời theo chính sách mới nhất.
Khi một tài liệu bị thu hồi quyền hoặc xóa, cả index và cache liên quan phải được làm mới. Monitoring cần theo dõi độ trễ cập nhật dữ liệu và chất lượng trích dẫn sau mỗi đợt thay đổi.
10. Kết luận
Một hệ thống RAG đáng tin cậy là sản phẩm của retrieval tốt, dữ liệu sạch, phân quyền chặt chẽ, chính sách trả lời có căn cứ và đánh giá liên tục. Chọn LLM chỉ là một phần của công việc kỹ thuật dài hạn.