

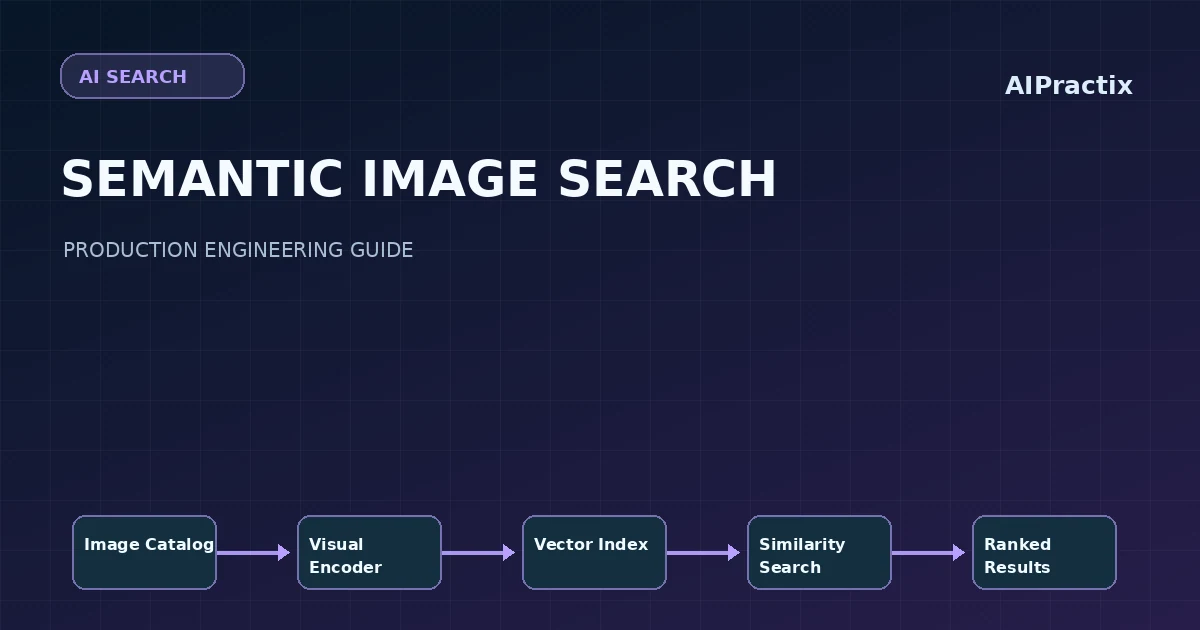
AIPractix · Technical Engineering · Kiến trúc hệ thống
1. Giới thiệu
Tìm kiếm ảnh truyền thống thường dựa vào tên file, tag và từ khóa thủ công. Semantic Image Search sử dụng biểu diễn học được để truy xuất hình ảnh tương tự về mặt thị giác hoặc ngữ nghĩa ngay cả khi không có nhãn text trùng khớp.
Một prototype có thể chỉ cần embedding model và thư viện nearest-neighbor. Một sản phẩm production còn cần ingestion, cập nhật index, metadata nhất quán, đánh giá mức liên quan và API cho hệ thống khách hàng.
AIPractix từng phát triển các bài toán retrieval qua FeatSearch. Bài viết bàn về nguyên tắc kiến trúc chung, không khẳng định những tính năng chưa được tài liệu hóa trong sản phẩm.
2. Xác định mục tiêu truy xuất
Image-to-image search nhận một ảnh mẫu và tìm các ảnh có đặc trưng gần nhau. Text-to-image search dùng truy vấn ngôn ngữ để tìm ảnh khi mô hình được huấn luyện cho liên kết đa phương thức.
Hai mục tiêu này có thể cần mô hình và dữ liệu đánh giá khác nhau. Người dùng tìm kính mắt có thể quan tâm kiểu dáng, màu sắc hoặc thương hiệu; hệ thống chỉ tối ưu similarity thị giác chưa chắc phù hợp ý định mua hàng.
Hãy định nghĩa “relevance” từ góc nhìn người sử dụng trước khi lựa chọn mô hình.
3. Xây dựng pipeline ingestion
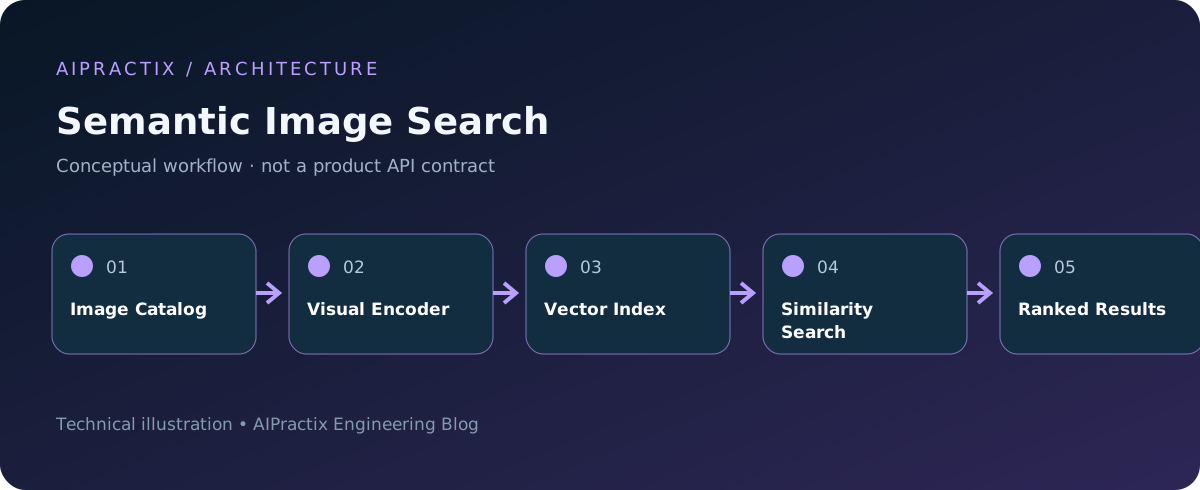
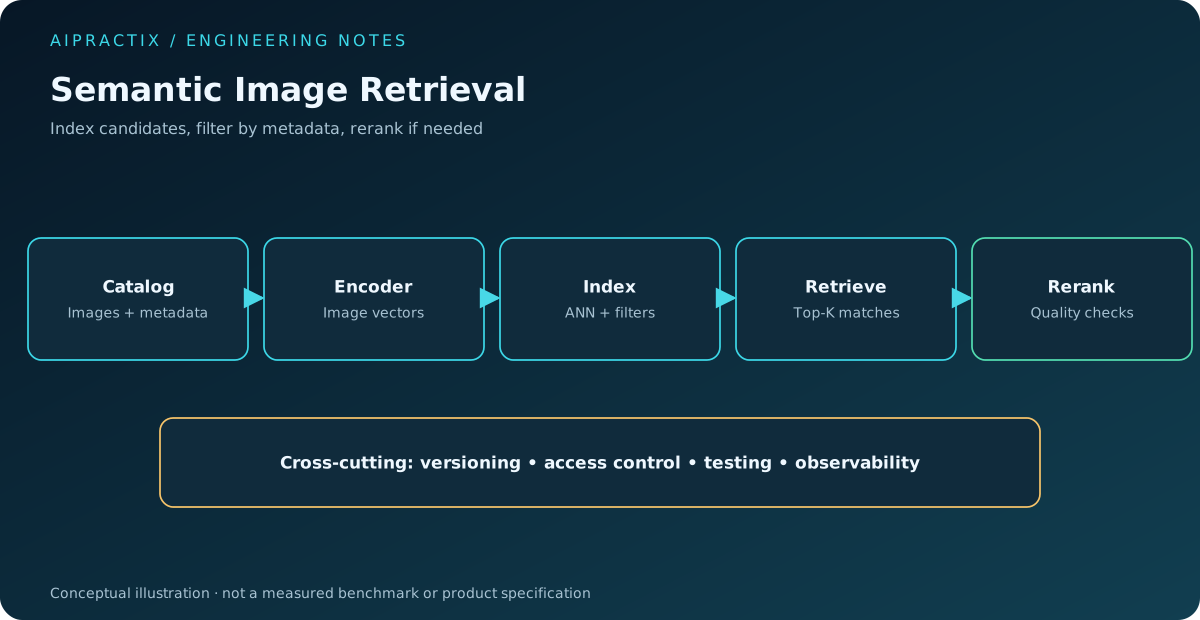
Nguồn dữ liệu có thể là catalog sản phẩm, thư viện ảnh, tài liệu số hoặc kho media. Mỗi ảnh cần được kiểm tra định dạng, chuẩn hóa kích thước, gắn mã định danh và liên kết metadata.
Sau đó, embedding model tạo vector và ghi vào vector index; database nghiệp vụ lưu mô tả, trạng thái hiển thị, quyền truy cập và các thuộc tính lọc. Nên có hàng đợi xử lý, cơ chế retry và theo dõi ảnh lỗi để tránh catalog bị thiếu âm thầm.
Khi ảnh được sửa hoặc xóa, vector tương ứng cũng phải được cập nhật hoặc xóa có kiểm soát.
4. Hiểu embedding và độ tương đồng
Embedding là vector trong không gian đặc trưng. Cosine similarity hoặc khoảng cách Euclidean có thể đo mức gần nhau nếu tương thích với cách mô hình được huấn luyện và chuẩn hóa.
Khoảng cách nhỏ không luôn đồng nghĩa “cùng sản phẩm”. Hai vật thể khác nhau có thể có hình dáng giống nhau, còn một sản phẩm chụp dưới nhiều góc có thể có embedding khác nhau. Vì vậy nên kiểm thử theo tiêu chí relevance cụ thể của nghiệp vụ.
5. Thiết kế lớp vector search
Ở quy mô nhỏ, exact nearest-neighbor search có thể đáp ứng. Khi catalog lớn, Approximate Nearest Neighbor (ANN) giúp giảm độ trễ bằng cách đánh đổi một phần khả năng tìm ứng viên gần nhất.
Cần theo dõi recall@K của index, tốc độ cập nhật, memory footprint, khả năng xóa dữ liệu và độ trễ truy vấn p95. Index nên có version gắn với embedding model để tránh trộn các vector không tương thích.
6. Kết hợp semantic search với metadata
Trong thương mại điện tử, người dùng thường muốn tìm “mẫu tương tự nhưng chỉ trong danh mục kính cận, dưới mức giá nhất định và còn hàng”. Vì vậy semantic retrieval cần kết hợp bộ lọc category, brand, price, availability và tenant permission.
Không nên để vector search trả về tài sản người dùng không có quyền xem rồi mới xử lý ở giao diện. Phân quyền phải được thực thi ở lớp retrieval và trả kết quả.
7. Cải thiện kết quả bằng reranking
Có thể lấy top-K ứng viên bằng ANN rồi rerank bằng mô hình mạnh hơn, metadata hoặc quy tắc nghiệp vụ. Ví dụ, reranker đánh giá mức tương tự kiểu dáng trong khi business layer ưu tiên sản phẩm còn tồn kho.
Đừng gộp điểm số từ các nguồn khác nhau mà không chuẩn hóa và kiểm thử. Cần đo lợi ích reranking trên dữ liệu thực so với chi phí độ trễ tăng thêm.
8. Đánh giá chất lượng tìm kiếm như một sản phẩm
Các chỉ số hữu ích gồm Recall@K, Precision@K, mAP hoặc NDCG, tùy bộ nhãn mức độ liên quan. Tuy nhiên, số liệu offline nên đi cùng phản hồi người dùng: tỷ lệ click, tìm lại, zero-result và mức hữu ích của danh sách kết quả.
Để tránh kết quả đẹp giả tạo, nên chia tập đánh giá theo sản phẩm và nguồn ảnh; bổ sung ảnh chụp thực tế, nền phức tạp, góc nhìn lạ và sản phẩm dễ nhầm lẫn.
9. Các vấn đề vận hành
Catalog thay đổi liên tục, vì vậy ingestion cần idempotency, quan sát queue lag và cơ chế phục hồi. Khi cập nhật model, phải quyết định cách re-embed toàn bộ catalog mà không làm gián đoạn API.
Cần theo dõi độ trễ, tỷ lệ truy vấn lỗi, kích thước index, chi phí lưu trữ và mức độ mới của dữ liệu. Với dữ liệu khách hàng, thiết lập quyền truy cập, chính sách lưu trữ và yêu cầu xóa thích hợp.
10. Kết luận
Một hệ thống Semantic Image Search tốt không chỉ tạo vector chính xác. Nó phải kết hợp ingestion đáng tin cậy, index hiệu quả, metadata, reranking và đánh giá relevance phù hợp với sản phẩm thực tế.