

AIPractix · Technical Engineering · Kiến trúc hệ thống
1. Hai giao diện tương tự, hai bài toán khác nhau
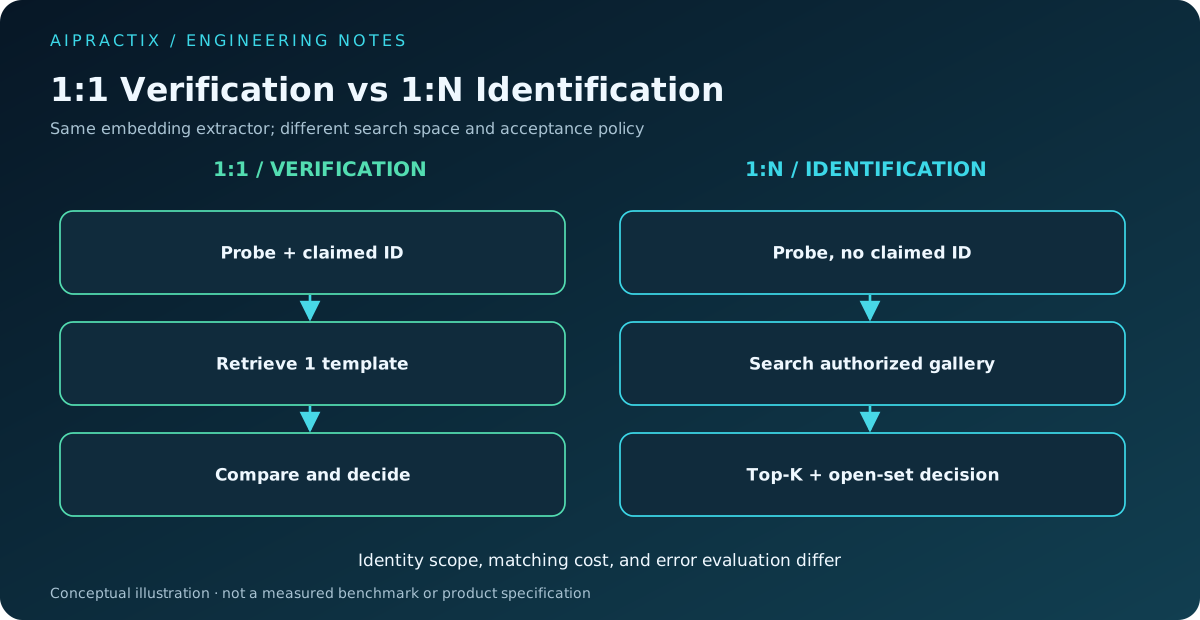
Người dùng thường gọi chung “nhận diện khuôn mặt”, nhưng verification (1:1) và identification (1:N) giải quyết hai câu hỏi rất khác nhau. Verification trả lời “Người này có phải danh tính họ khai báo không?”; identification trả lời “Người này có nằm trong tập danh tính được phép tìm kiếm không?”.
Sự khác biệt ảnh hưởng đến API, thiết kế cơ sở dữ liệu, độ trễ, phân quyền và xác suất nhận dạng sai. Một chức năng chấm công gắn với tài khoản đã đăng nhập không nhất thiết cần tìm toàn bộ nhân viên.
2. Pipeline phân tích chung
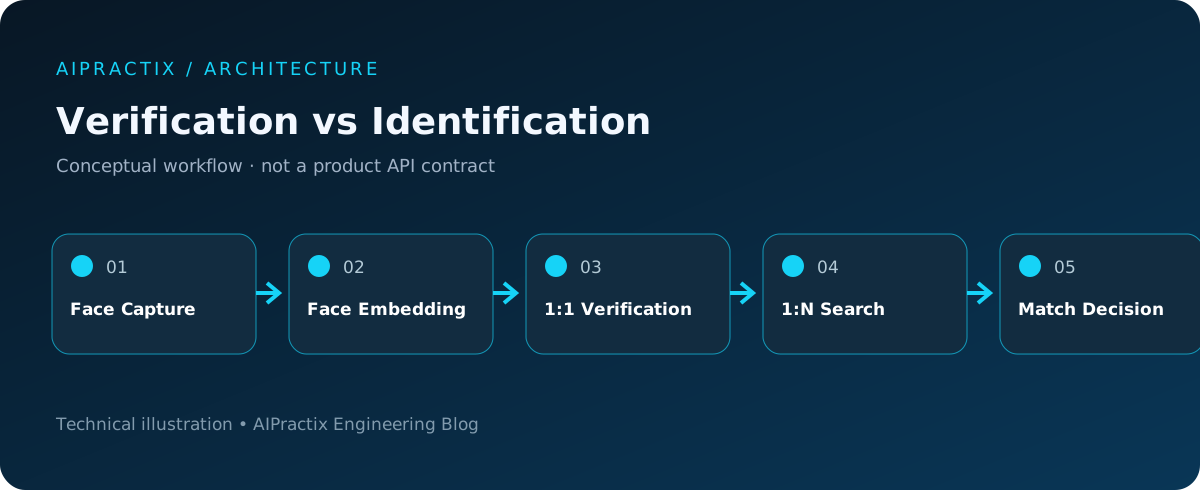
Cả hai thường bắt đầu bằng phát hiện khuôn mặt, kiểm tra chất lượng, căn chỉnh và trích xuất embedding. Khi có yêu cầu chống giả mạo, PAD được đánh giá theo chính sách ứng dụng.
Embedding là vector biểu diễn đặc trưng khuôn mặt. Hai vector có thể được so sánh bằng cosine similarity hoặc độ đo tương thích với mô hình. Điểm similarity không đồng nghĩa xác suất xác nhận danh tính; chỉ số này cần ngưỡng được hiệu chỉnh trên dữ liệu mục tiêu.
3. Verification: So khớp 1:1
Trong 1:1, ứng dụng biết danh tính được khai báo (ví dụ nhân viên đã đăng nhập) và lấy mẫu của đúng người đó. Hệ thống so sánh embedding mới với một hoặc nhiều mẫu đã đăng ký rồi trả về kết quả theo ngưỡng.
Cần phân biệt lỗi không tìm thấy tài khoản, chưa có mẫu, ảnh không đạt chất lượng và khuôn mặt không khớp. Việc từ chối phải được kiểm toán mà không ghi lộ embedding hoặc ảnh nhạy cảm vào log thông thường.
1:1 thường có chi phí tra cứu dễ dự đoán hơn, bởi không phải tìm kiếm toàn bộ gallery.
4. Identification: Tìm kiếm 1:N
Trong 1:N, hệ thống so sánh khuôn mặt đầu vào với một gallery gồm nhiều người và trả về danh sách ứng viên. Với open-set identification, hệ thống còn phải chấp nhận khả năng người được quan sát không thuộc gallery.
Một điểm số cao nhất không tự động là kết quả hợp lệ. Khi số người trong gallery tăng, khả năng xuất hiện ứng viên trùng điểm ngẫu nhiên cũng có thể tăng; vì vậy phải đánh giá sai nhận dạng theo đúng quy mô triển khai.
5. Kiến trúc tìm kiếm cho gallery lớn
Với tập dữ liệu nhỏ, có thể so sánh tuần tự các embedding. Khi số danh tính tăng, hệ thống có thể áp dụng vector index hoặc Approximate Nearest Neighbor (ANN) để giảm thời gian tìm ứng viên, sau đó tính lại similarity và áp dụng ngưỡng quyết định.
ANN thường đánh đổi tốc độ và khả năng tìm đúng láng giềng gần nhất. Cần đo recall của index, độ trễ, bộ nhớ và ảnh hưởng của cập nhật/xóa mẫu. Không được bỏ qua lọc tenant hoặc quyền truy cập trước và sau tìm kiếm.
6. Nhiều mẫu cho một người
Một danh tính có thể có ảnh từ các góc, thiết bị hoặc thời điểm khác nhau. Nhiều template giúp tăng độ bao phủ, nhưng cũng phát sinh câu hỏi: chọn kết quả tốt nhất, lấy trung bình embedding hay áp dụng quy tắc tổng hợp?
Không có câu trả lời phù hợp mọi mô hình. Chính sách gộp mẫu phải được đánh giá để tránh vô tình tăng false match, đồng thời có quy trình loại bỏ mẫu cũ/kém chất lượng khi đăng ký lại.
7. Sai khớp phải được đặt trong ngữ cảnh
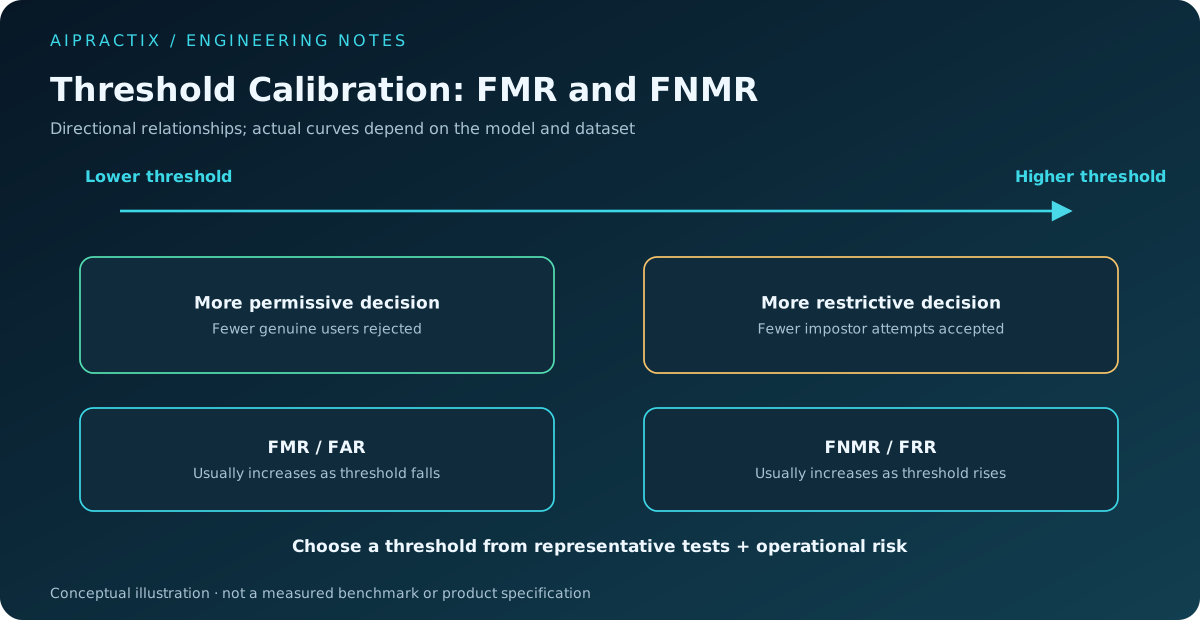
Với 1:1, quan tâm thường là FMR và FNMR tại ngưỡng xác định. Với 1:N, cần đo nhận dạng sai với người ngoài gallery, khả năng tìm đúng trong gallery và ảnh hưởng của kích thước gallery.
Một threshold phù hợp cho ứng dụng tiện lợi có thể không đủ an toàn cho xác minh danh tính có hệ quả tài chính. Cần thống nhất mức rủi ro trước khi tối ưu chỉ số.
8. Tình huống ứng dụng và đánh đổi
Xác minh đăng nhập, xác nhận đúng người khi hoàn tất thao tác hoặc kiểm tra danh tính tại quầy thường phù hợp 1:1. Kiosk chấm công chung có thể cần 1:N để tìm người mà không yêu cầu nhập mã nhân viên.
Đối với camera công cộng hoặc môi trường nhiều người, nhận dạng 1:N đòi hỏi đánh giá đặc biệt nghiêm ngặt về quyền riêng tư, tính phù hợp pháp lý và mức sai nhận dạng. Không nên mặc định mọi bài toán phát hiện người đều cần xác định danh tính.
9. Phiên bản mô hình và quản trị dữ liệu
Nếu thay đổi detector, alignment hoặc model embedding, các vector cũ có thể không còn so sánh tương thích với vector mới. Hãy ghi rõ version của pipeline, có kế hoạch tái tạo index và hỗ trợ migration.
Quyền đăng ký/xóa dữ liệu, thời hạn lưu trữ, tenant isolation và audit trail cần được thiết kế ngay từ đầu cho cả 1:1 lẫn 1:N.
10. Kết luận
1:1 và 1:N không chỉ khác ở số lượng phép so sánh. Chúng là hai nghiệp vụ với yêu cầu bảo mật, hiệu năng và đánh giá riêng. Tách chúng từ lớp API đến vận hành giúp một Face AI engine phục vụ nhiều sản phẩm mà vẫn dễ kiểm soát.