

AIPractix · Technical Engineering · Kiến trúc hệ thống
1. Quyết định triển khai quan trọng hơn tưởng tượng
Cùng một mô hình nhận diện khuôn mặt có thể được chạy trên điện thoại, máy chủ nội bộ hoặc hạ tầng đám mây. Nhưng vị trí inference ảnh hưởng đến toàn bộ trải nghiệm: độ trễ, chi phí kết nối, quy trình nâng cấp, bảo vệ dữ liệu và khả năng hoạt động khi mất mạng.
Vì thế, chọn on-device hay server không nên chỉ dựa vào điểm benchmark của một model; đó là quyết định kiến trúc của sản phẩm.
2. Ba kiểu triển khai phổ biến
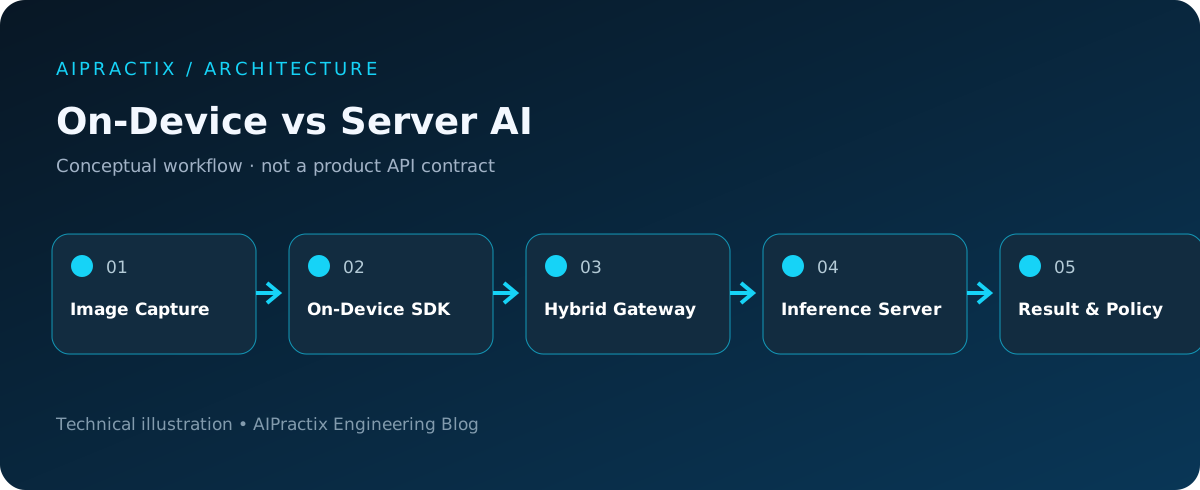
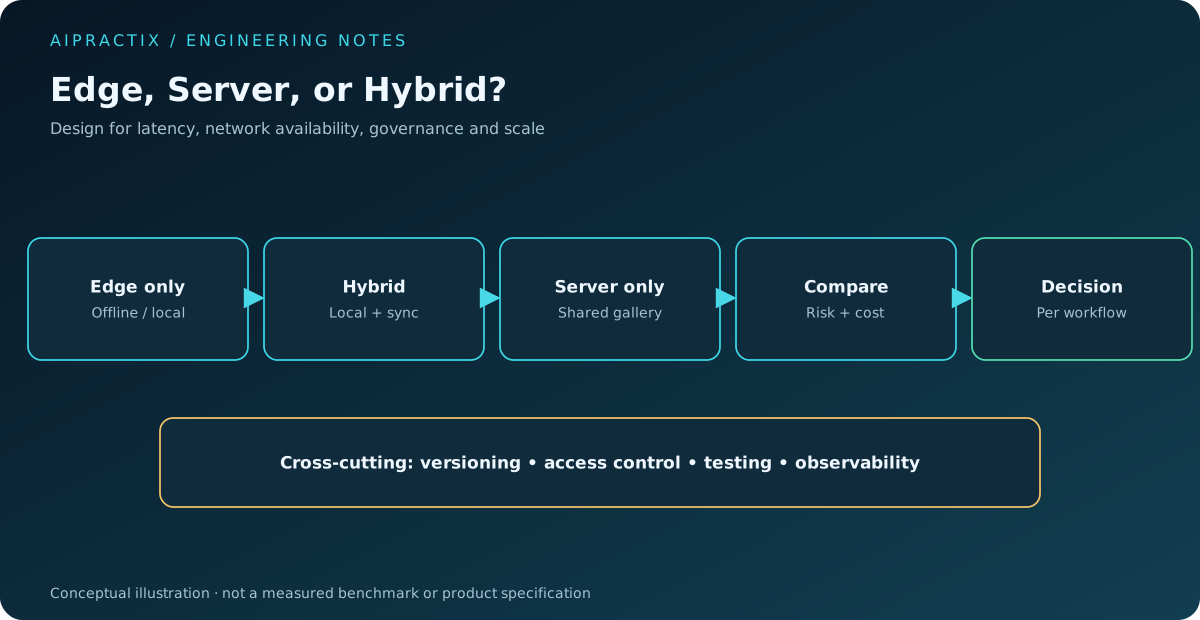
On-device: Ứng dụng chạy face detection, alignment, recognition và có thể cả liveness cục bộ. Server-based: client gửi dữ liệu phù hợp đến dịch vụ tập trung để xử lý. Hybrid: các bước nhạy độ trễ chạy ở thiết bị, còn quản lý danh tính hoặc nghiệp vụ nằm ở server.
Mỗi kiểu đều có biến thể. Ví dụ, một ứng dụng có thể tạo embedding tại thiết bị rồi gửi vector để tìm kiếm tập trung; cách làm này vẫn cần bảo vệ dữ liệu sinh trắc học và thiết kế kiểm soát truy cập.
3. So sánh các đánh đổi chính
| Tiêu chí | On-device | Server-based | Hybrid |
|---|---|---|---|
| Mất mạng | Có thể tiếp tục xử lý cục bộ | Thường bị ảnh hưởng | Tùy chức năng |
| Độ trễ mạng | Ít phụ thuộc | Phụ thuộc đường truyền | Có thể tối ưu |
| Nâng cấp model | Phụ thuộc chu kỳ cập nhật app | Quản lý tập trung | Cần đồng bộ version |
| Tài nguyên | Giới hạn bởi thiết bị | Dùng chung CPU/GPU | Phân bổ linh hoạt |
| Kiểm soát dữ liệu | Giảm nhu cầu truyền ảnh | Dễ quản trị tập trung | Cần mô hình dữ liệu rõ |
Không hàng nào trong bảng tự động quyết định phương án tối ưu. Hãy xét mục tiêu, quy mô, ngân sách và mức rủi ro cụ thể.
4. Độ trễ là thuộc tính end-to-end
Thời gian người dùng chờ không chỉ là inference latency. Nó còn bao gồm thu frame, tiền xử lý, chuyển dữ liệu qua JNI/bridge, upload ảnh nếu có, hàng đợi server, truy vấn facebank và render UI.
Một model chạy nhanh trên GPU server vẫn có thể tạo trải nghiệm chậm hơn điện thoại vì độ trễ mạng. Ngược lại, thiết bị giá rẻ có thể xử lý chậm hơn server khi phải chạy nhiều mô hình liên tục. Hãy đo cùng một workflow thật trên nhiều nhóm thiết bị.
5. Quyền riêng tư cần sơ đồ luồng dữ liệu
On-device giúp giảm nhu cầu gửi ảnh khuôn mặt lên server, nhưng vẫn cần biết embedding và lịch sử nhận diện được lưu ở đâu. Server tập trung thuận tiện cho quản trị và thu hồi quyền, song gia tăng trách nhiệm bảo mật cơ sở dữ liệu và kênh truyền.
Với từng dữ liệu — ảnh gốc, ảnh căn chỉnh, embedding, kết quả so khớp, nhật ký — hãy xác định người quản lý, mục đích, thời hạn lưu và cơ chế xóa.
6. Vòng đời mô hình và tương thích phiên bản
Model embedding, chuẩn alignment hoặc detector thay đổi có thể làm similarity score bị lệch và khiến facebank cũ mất tính tương thích. Trên server, nâng cấp có thể được kiểm soát tập trung; với app di động, nhiều phiên bản SDK thường tồn tại song song.
Do đó nên version toàn bộ pipeline, xác định chính sách migration và đặt quy tắc không so sánh embedding không tương thích. Cũng cần plan rollback khi bản cập nhật gây suy giảm chất lượng.
7. Khả năng mở rộng và tổng chi phí
On-device phân bổ chi phí inference ra hàng trăm hoặc hàng nghìn thiết bị, giảm nhu cầu GPU tập trung nhưng tăng công kiểm thử tương thích. Server cần ngân sách CPU/GPU, network, lưu trữ và giám sát, đổi lại có thể dùng chung tài nguyên và điều chỉnh tập trung.
Tổng chi phí sở hữu còn gồm phát triển SDK, hỗ trợ tích hợp, quản lý giấy phép, bảo trì, vận hành, hỗ trợ khách hàng và rủi ro downtime. Một cấu hình rẻ khi chạy thử chưa chắc rẻ ở quy mô sản phẩm.
8. Ví dụ quyết định kiến trúc
Chấm công trên điện thoại tại nơi mạng yếu thường hưởng lợi từ xử lý cục bộ và hàng đợi sync. Một nền tảng nhiều ứng dụng dùng chung tập danh tính lớn có thể cần dịch vụ matching tập trung. Kiosk ở nhiều chi nhánh có thể áp dụng hybrid: nhận diện tại chỗ, đồng bộ chính sách và báo cáo về trung tâm.
Bất kể cấu hình nào, quyết định cuối cùng cần dựa trên phép thử tải và bảo mật trong môi trường thật.
9. Checklist khi review kiến trúc
Hãy trả lời: có cần hoạt động offline không; gallery lớn bao nhiêu; độ trễ p95 chấp nhận là bao nhiêu; ai sở hữu dữ liệu sinh trắc học; model cập nhật thế nào; thiết bị thấp nhất là gì; cơ chế hủy quyền ra sao; và chi phí vận hành theo năm sẽ biến đổi như thế nào?
Nếu chưa có câu trả lời, hãy xây prototype để đo trước khi khóa lựa chọn công nghệ.
10. Kết luận
Không có kiến trúc Face AI tốt nhất cho mọi sản phẩm. On-device, server và hybrid đều có vai trò riêng. Thiết kế tốt là thiết kế đáp ứng yêu cầu vận hành, quyền riêng tư và khả năng phát triển trong dài hạn.